
Servicios de traducción de documentos de secuenciación genómica
Traducción de secuenciación genómica: informes de exoma (WES), paneles de genes y anotaciones bioinformáticas, con confidencialidad RGPD. Pide presupuesto.
Precisión terminológica en datos genómicos y bioinformáticos
La traducción de secuenciación genómica y anotaciones es esencial para garantizar la correcta interpretación de datos biológicos en investigación, patentes y registros internacionales. En BeTranslated, traductores científicos especializados aseguran precisión terminológica, coherencia bioinformática y confidencialidad en proyectos genómicos globales.
¿Qué exige la traducción de documentos de secuenciación genómica?
La traducción de informes de secuenciación genómica y anotaciones exige un dominio riguroso de la terminología bioinformática y genética. Estos documentos son clave para investigación biomédica, biotecnología, patentes y registros regulatorios internacionales.
En BeTranslated, traductores científicos especializados garantizan coherencia terminológica, fidelidad a bases de datos y compatibilidad con estándares internacionales de anotación genética.
Traducción de secuenciación genómica y anotaciones: precisión que no admite reinterpretación
Los informes de secuenciación genómica contienen datos que alimentan bases de datos regulatorias, decisiones diagnósticas y publicaciones científicas. Un término mal traducido, una métrica alterada o una nomenclatura inconsistente pueden comprometer la validez de un informe clínico o la replicabilidad de un experimento.
FASTA, FASTQ, GFF, VCF: la estructura y metadatos deben preservarse
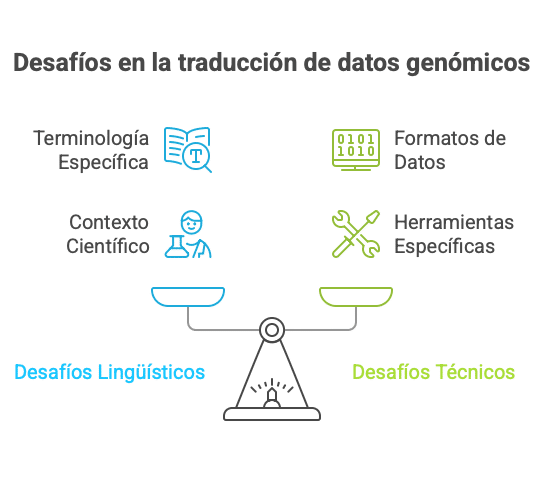
Los informes de secuenciación usan formatos como FASTA, FASTQ, GFF, GTF, BED y VCF; la traducción debe preservar la estructura, los encabezados y los metadatos para mantener compatibilidad con pipelines bioinformáticos estándar.
Estándares de formatos bioinformáticos – Formatos de archivo utilizados en secuenciación de nueva generación (PDF en español, Universidad de Salamanca)
En BeTranslated trabajamos con formatos bioinformáticos estructurados (FASTA, FASTQ, BAM/CRAM, GFF/GTF, VCF) y documentos convencionales (Word, PDF, Excel, InDesign). Cubrimos las principales combinaciones lingüísticas en genética y biotecnología: español, inglés, francés, alemán, italiano, portugués, neerlandés, árabe y chino.
Traducción científica especializada vs. traducción general
Una traducción científica no es solo cambiar palabras de un idioma a otro. Es un proceso técnico que requiere interpretar la documentación de secuenciación genómica dentro de su contexto experimental o clínico.
| Característica | Traducción general | Traducción científica especializada |
|---|---|---|
| Conocimiento técnico | Básico o nulo | Profundo en genética, bioinformática y biología molecular |
| Manejo de formatos | Solo texto plano | FASTA, GFF, BAM/CRAM, GFF/GTF, VCF, PDF, Word, InDesign |
| Terminología | Generalista | Especializada y validada con bases de datos científicas |
| Uso típico | Contenido informativo | Investigación, patentes, diagnóstico clínico, regulación |
Cuándo es imprescindible
- Publicación de artículos científicos en revistas internacionales
- Presentación de patentes biotecnológicas ante oficinas europeas o mundiales
- Compartir resultados de secuenciación con colaboradores extranjeros
- Registro de ensayos clínicos o productos sanitarios
- Traducción de informes de diagnóstico genético para pacientes internacionales
- Localización de bases de datos de variantes genéticas
Requisitos técnicos específicos de estos documentos
Nomenclatura HGVS y bases de datos regulatorias
Las variantes genéticas se describen con una nomenclatura HGVS estandarizada (por ejemplo, c.1234G>A, p.Leu412Pro). Estas notaciones deben preservarse literalmente, sin reinterpretación, porque cualquier alteración puede afectar a las anotaciones en bases de datos como ClinVar, Ensembl y repositorios regulatorios internacionales.
Leer más
SNP, CNV, frameshift, missense: implicaciones clínicas directas
SNP, CNV, indels, frameshift y missense mutations requieren traducción contextualizada con conocimiento de biología molecular; términos como «patogénico», «VUS» o «benigno» tienen implicaciones clínicas directas.
Clasificación de variantes y genética clínica – Catálogo de pruebas genéticas/genómicas del Sistema Nacional de Salud (PDF en español, Ministerio de Sanidad) y Genotipia: Anotación y clasificación de variantes genéticas (en español)
Phred scores, cobertura y métricas de calidad
Los informes FASTQ incluyen Phred quality scores (por ejemplo, Q30 ≈ 99,9 % de precisión por base) que determinan la fiabilidad de las variantes detectadas. La traducción debe conservar estas métricas, la cobertura media y la distribución de heterocigosidad para que la validación bioinformática posterior sea posible.
Leer más
WES vs WGS: del exoma (1-2 % del genoma) al genoma completo
El exoma completo (WES) analiza las regiones codificantes, en torno al 1-2 % del genoma, frente al genoma completo (WGS); la traducción debe diferenciar cobertura, profundidad de lecturas y regiones intrónicas/intergénicas para una interpretación diagnóstica correcta.
Comparativa WES vs WGS y genómica – Genome.gov – sección de genómica (en español)
Criterios ACMG/AMP y comunicación a comités éticos
Los criterios ACMG/AMP (PVS1, PS1–4, PM1–6, PP1–5, BA1, BS1–4, BP1–7, etc.) para la clasificación de patogenicidad de variantes deben traducirse sin ambigüedad para garantizar una comunicación coherente ante comités éticos y agencias reguladoras.
Leer más
HGNC, RefSeq, Ensembl, ClinVar: coherencia entre jurisdicciones
Las anotaciones deben alinearse con HGNC, RefSeq (NM_, NP_), Ensembl (ENST), UniProt, dbSNP y ClinVar; glosarios validados garantizan interoperabilidad entre jurisdicciones clínicas e investigativas.
Bases de datos y genética clínica – Glosario de genética y genómica (Genome.gov, en español) y Genotipia: Anotación y clasificación de variantes genéticas (en español)
Experiencia en anotaciones bioinformáticas
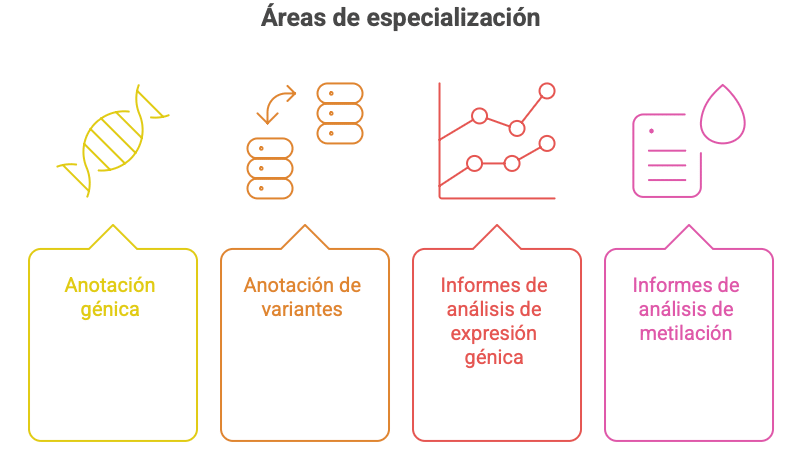
Las anotaciones bioinformáticas transforman secuencias crudas en información biológicamente significativa: identifican genes, predicen funciones proteicas y detectan variantes. En BeTranslated traducimos:
- Anotación génica: descripción de función, localización y regulación de genes
- Anotación de variantes: identificación y caracterización de polimorfismos y mutaciones relevantes para enfermedades
- Informes de análisis de expresión génica: datos sobre la actividad de los genes
- Informes de análisis de metilación: modificaciones epigenéticas del ADN
Tipos de secuenciación que manejamos
A continuación, los tipos de secuenciación cuyos informes y documentación se traducen con mayor frecuencia:
Secuenciación de exoma completo (WES)
Análisis de regiones codificantes (exones) para identificar variantes asociadas a enfermedades.
Ejemplos de documentos: informes de análisis de variantes en exomas, paneles de genes vinculados a enfermedades raras.
Secuenciación de genoma completo (WGS)
Estudio de todo el genoma, con regiones codificantes y no codificantes, para una visión exhaustiva.
Ejemplos de documentos: informes de secuenciación de genoma completo, estudios de genomas de poblaciones.
paneles genéticos dirigidos
Secuenciación de genes o regiones concretas, habitual en diagnóstico o investigación aplicada.
Ejemplos de documentos: resultados de paneles oncológicos, paneles de cardiomiopatías, informes de pruebas genéticas.
Proceso de calidad y confidencialidad RGPD
Los datos genéticos son una categoría especial de datos personales según el artículo 9 del RGPD, lo que exige garantías reforzadas de confidencialidad y seguridad. Todos nuestros traductores firman acuerdos de confidencialidad antes de acceder a cualquier documento, y nuestros procesos cumplen con estos requisitos desde el primer momento.
Datos genómicos: «datos especiales» bajo RGPD con obligaciones estrictas
Los datos genómicos humanos clasificados como datos especiales bajo el RGPD requieren garantías reforzadas, como la confidencialidad, el cifrado y el acceso restringido; el incumplimiento puede acarrear multas de hasta 20 millones de euros o el 4 % del volumen de negocio anual global.
Datos genéticos y RGPD – RGPD, artículo 9 (versión en español, EUR‑Lex)
Traducción de secuenciación genómica y anotaciones
Traducimos informes de secuenciación genómica, anotaciones bioinformáticas y la documentación relacionada, con traductores con formación en genética, biología molecular y bioinformática.
Formatos e idiomas
- Formatos bioinformáticos: FASTA, FASTQ, BAM/CRAM, GFF/GTF, BED y VCF, conservando encabezados y metadatos para que sigan siendo compatibles con tus flujos de análisis.
- Documentos habituales: Word, PDF, Excel e InDesign.
- Idiomas: español, inglés, francés, alemán, italiano, portugués, neerlandés, árabe y chino.
Requisitos técnicos de estos documentos
- La nomenclatura HGVS de las variantes se mantiene tal cual, sin reinterpretarla.
- Términos como «patogénico», «VUS» o «benigno» tienen implicaciones clínicas y se traducen según el contexto.
- Los criterios ACMG/AMP se traducen sin ambigüedad.
- La terminología es coherente con bases de datos como HGNC, RefSeq, Ensembl, UniProt, dbSNP y ClinVar.
Tipos de secuenciación
- Exoma completo (WES): las regiones codificantes del genoma.
- Genoma completo (WGS): todo el genoma, incluidas las regiones no codificantes.
- Paneles dirigidos: genes concretos, habituales en diagnóstico oncológico, cardiológico o de enfermedades raras.
Confidencialidad y RGPD
Los datos genómicos son datos especiales según el RGPD. Firmamos acuerdos de confidencialidad (NDA) y los traductores los firman antes de acceder a los documentos.
Escenarios típicos
Los ejemplos siguientes no son proyectos concretos de clientes, sino escenarios típicos: informes de diagnóstico prenatal no invasivo del español al inglés, bases de datos de variantes genéticas al alemán y al francés, o artículos sobre CRISPR-Cas9 del alemán al español.
Preguntas frecuentes sobre la traducción de documentos de secuenciación genómica
¿Qué formatos de archivo admitís para la traducción de secuenciación genómica?
Formatos bioinformáticos como FASTA, FASTQ, BAM/CRAM, GFF/GTF y VCF, además de documentos convencionales como Word, PDF, Excel e InDesign. Nuestro equipo técnico está preparado para trabajar con los datos en el formato en que se generen.
¿Cómo garantizáis la confidencialidad de mis datos genéticos?
Todos nuestros traductores firman acuerdos de confidencialidad y seguimos protocolos conformes al RGPD, incluyendo cifrado y acceso restringido. Los datos genómicos están clasificados como datos especiales bajo el RGPD y los tratamos con las medidas correspondientes.
¿Los traductores tienen experiencia en bioinformática?
Sí, seleccionamos traductores con formación y experiencia en bioinformática, genética o biología molecular. Conocen herramientas como GATK, VEP o ANNOVAR y bases de datos como ClinVar, Ensembl o dbSNP.
¿Ofrecéis servicios de traducción urgente para proyectos genómicos?
Consúltanos: la entrega urgente es excepcional, tiene recargo y te confirmamos el plazo con el presupuesto.
¿Cómo puedo solicitar un presupuesto?
A través de nuestra página de presupuesto en línea, adjuntando los documentos e indicando los idiomas. Te enviaremos una propuesta detallada sin compromiso en un máximo de 8 horas laborables.
Más preguntas frecuentes
¿Qué formatos aceptáis?
Formatos bioinformáticos (FASTA, FASTQ, BAM/CRAM, GFF/GTF, VCF) y documentos ofimáticos.
¿Firmáis un acuerdo de confidencialidad (NDA) antes de ver los informes?
Sí. Firmamos un NDA si lo necesitas y los traductores también firman acuerdos de confidencialidad.
¿Me podéis dar un precio orientativo antes de enviar los documentos?
Te enviamos un presupuesto cuando vemos los documentos y los idiomas. Pide presupuesto desde la página de presupuesto de traducción y respondemos en un máximo de 8 horas laborables.
¿Necesitas traducir informes de secuenciación genómica y anotaciones?
En BeTranslated, combinamos experiencia en genética, biología molecular y bioinformática para entregar traducciones precisas, estructuradas y alineadas con publicaciones científicas y requisitos regulatorios.